deepseek 的 ced 为什么会"自然分化"目录deepseek 的 ced 为什么会"自然分化"CED 到底在干什么?——把 Transformer 掰开讲清楚一、先放结论:一句话版二、先把普通 Transformer 讲透:每层都在干什么普通 LLM 的一次推理这就是 KV cache 吃显存的根源三、CED 做了什么:后 20 层不许开账本KV 账本从此只有半本四、训练过程?和 GPT 一模一样举个例子和 BERT 的区别具体规模(V4.1-Flash 官方数字)五、前 20 和后 20 训练一样吗?——同一次反向传播,角色不同为什么会"自然分化"架构不同,但"训练方式"相同六、为什么叫 "encoder-decoder"?—— 一个有争议的命名传统 encoder-decoder(T5、BART、机器翻译模型)CED 的 "encoder-decoder"七、这件事为什么有效?1. 高层本来就依赖低层2. H₂₀ 已经"懂了"3. 投影矩阵补了灵活度4. 滑动窗口兜底训练到推理的全景一图 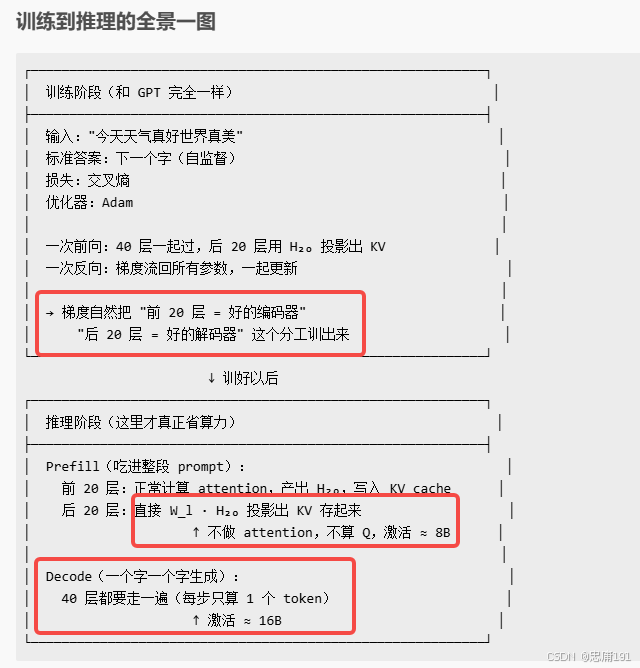十、给你的三个带走要点想象你在训"今天天气真→好"这条样本:前向:输入过 40 层,最后一层输出"好"的概率分布算 loss:和真实下一个字比,损失函数求偏差反向:梯度从最后一层一路流回第 1 层关键在反向这一步:后 20 层学到:“要用 H₂₀ 预测下一个字”,所以它们学会从 H₂₀ 里挑有用的信息。前 20 层(尤其是第 20 层)学到:“H₂₀ 必须包含后 20 层需要的所有信息”,所以第 20 层会被梯度逼着成为一个"浓缩良好"的表示。CED 到底在干什么?——把 Transformer 掰开讲清楚你问的四件事:训练过程、标准答案、前后 20 层的差别、为什么叫 encoder/decoder,其实是同一件事的四个侧面。看完这篇你会发现:CED 没有什么"新训练方法",训练过程和 GPT 一模一样,唯一特别的只是"换了一种搭积木的方式"。一、先放结论:一句话版CED = 把 40 层积木,前 20 层让它老老实实搭 KV 库存,后 20 层不许自己搭 KV,强行"借"前 20 层的用。训练目标和 GPT 一模一样——猜下一个字。就这么简单。所有复杂性都在"借 KV"这一个动作上。